CPF
Digite um CPF no formato 000.000.000-00:
O CPF (Cadastro de Pessoa Física) de um contribuinte consiste de 9 números e dois dígitos verificadores. Os dígitos verificadores são assim chamados porque são determinados por operações realizadas nos números: se algum deles estiver errado, os dígitos verificadores não serão iguais aos que podem ser calculados. O algoritmo que os define funciona assim:
Multiplique o primeiro número por 10, o segundo por 9, o terceiro por 8 e assim por diante até o nono número, que é multiplicado por 2. Some tudo e divida o total por 11. Se o resto da divisão for menor que 2, o primeiro dígito verificador é 0; caso contrário é a diferença entre 11 e o resto.
Para gerar o segundo dígito verificador o procedimento é semelhante, mas inclui o primeiro dígito verificador: multiplique o primeiro número por 11, o segundo por 10, o terceiro por 9 e assim por diante até o nono, que é multiplicado por 3. Multiplique o primeiro dígito verificador por 2. Some tudo e divida por 11. Se o resto da divisão for menor que 2, o segundo dígito verificador é 0; caso contrário é a diferença entre 11 e o resto.
Formalmente, o algoritmo pode ser expresso como segue, partindo-se de um número inteiro $N$ formado por 9 algarismos $a_1$, $a_2$, ..., $a_9$ e utilizando-se $a \mathbin{\%} b$ para indicar a operação que retorna o resto da divisão de $a$ por $b$:
\begin{eqnarray} N & = & \{a_1, a_2, ..., a_9\} \\ s_1 & = & \sum_{i=1}^{9} (11-i) \times a_i \\ r_1 & = & s_1\mathbin{\%}11 \\ d_1 & = & { \begin{cases} 0 & \text{ se } r_1 < 2 \\ 11-r_1 & \text{ se } r_1 \ge 2 \end{cases} } \\ s_2 & = & \sum_{i=1}^{9} (12-i) \times a_i + 2 \times d_1 \\ r_2 & = & s_2\mathbin{\%}11 \\ d_2 & = & { \begin{cases} 0 & \text{ se } r_2 < 2 \\ 11-r_2 & \text{ se } r_2 \ge 2 \end{cases} } \\ \end{eqnarray}Estratégias conceitualmente idênticas são utilizadas para gerar dígitos verificadores em várias outras instâncias (título de eleitor, carteira de identidade, registros civis etc.)
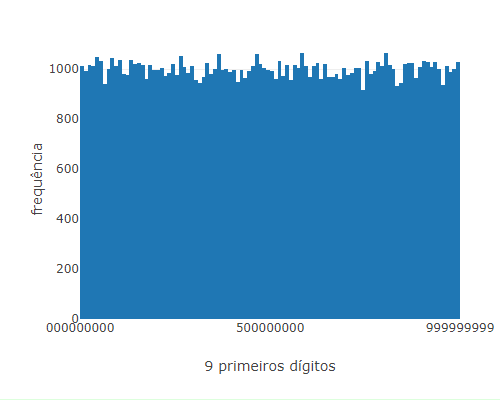
A figura a seguir mostra a distribuição de 100 mil "CPFs" aleatórios entre 000000000 e 999999999 construídos a partir de uma distribuição uniforme, onde se vê aproximadamente 1000 CPFs em cada um dos 100 canais do histograma. Cada canal do histograma contempla um intervalo de 10 milhões de CPFs (canal 0, por exemplo, contempla CPFs que vão de 000000000 a 009999999).
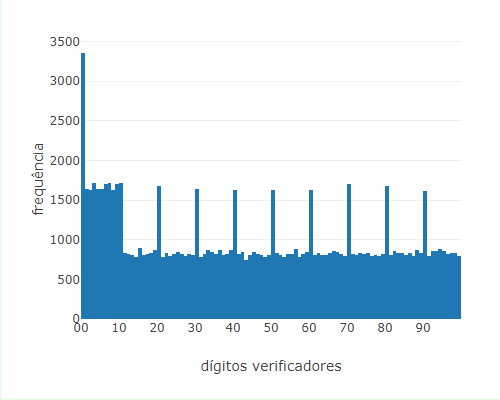
A figura a seguir mostra a distribuição dos dígitos verificadores desses CPFs. O histograma também tem 100 canais, o que significa que cada canal corresponde a um único conjunto de dígitos verificadores (00 a 99). Observa-se que os conjuntos de dígitos verificadores não têm a mesma probabilidade de ocorrer.
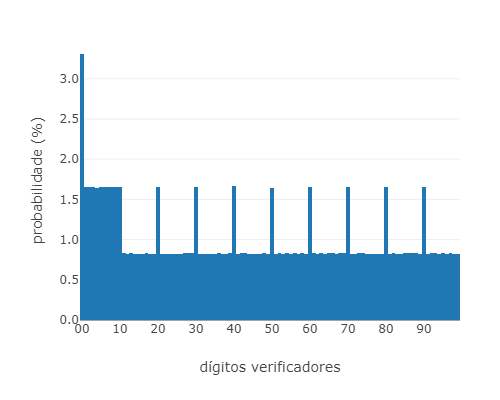
A figura a seguir mostra essencialmente a mesma distribuição, mas obtida com muito mais dados (10 milhões) e normalizada pelo número de dados, o que permite ver adequadamente a probabilidade de ocorrência de cada conjunto de dígitos verificadores: 00 ocorre em cerca de 3,32% dos casos; 01, 02, 03, 04, 05, 06, 07, 08, 09, 10, 20, 30, 40, 50, 60, 70, 80 e 90, cada um, em cerca de 1,66% dos casos; os demais (11 a 19, 21 a 29 etc.), em 0,83% dos casos (a soma disso tudo compõe 100% para 3 algarismos significativos).
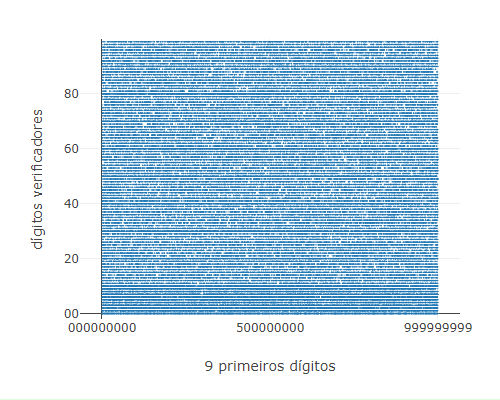
A figura a seguir mostra a correlação entre as duas distribuições, e mostra que as probabilidades dos conjuntos de dígitos verificadores são homogeneamente distribuídas ao longo de todo o intervalo de CPFs.
A figura a seguir mostra a distribuição de 100 mil "CPFs" aleatórios entre 020200000 e 020209999 construídos a partir de uma distribuição uniforme, onde se vê aproximadamente 1000 CPFs em cada um dos 100 canais do histograma. Cada canal do histograma contempla um intervalo de 100 CPFs (canal 0, por exemplo, contempla CPFs que vão de 020200000 a 020200099).
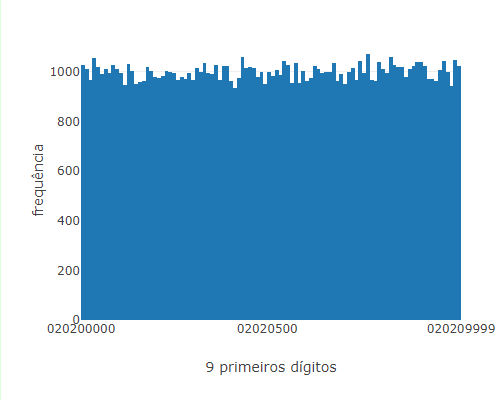
A figura a seguir mostra a distribuição dos dígitos verificadores desses CPFs. O histograma também tem 100 canais, o que significa que cada canal corresponde a um único conjunto de dígitos verificadores (00 a 99). Observa-se que os conjuntos de dígitos verificadores não têm a mesma probabilidade de ocorrer, mas seguem o mesmo padrão encontrado anteriormente. Ou seja, as probabilidades relativas de cada conjunto de dígitos verificadores, neste conjunto muito menor de possibilidades (10 mil), são as mesmas que as encontradas para o conjunto maior (1 bilhão).
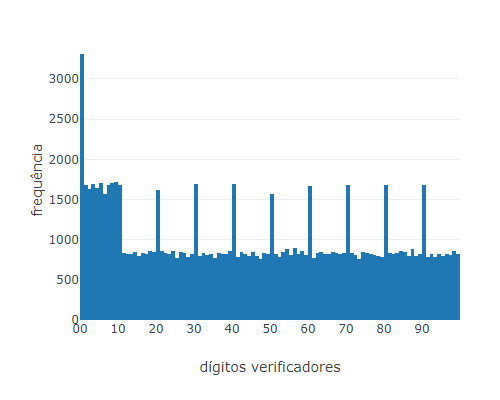
A figura a seguir mostra a correlação entre as duas distribuições, e mostra que as probabilidades dos conjuntos de dígitos verificadores são bem distribuídas ao longo de todo o intervalo de CPFs, que não são tão homogêneas quanto as encontradas nos dados anteriores (notam-se "vazios" ao longo de linhas diagonais na figura).
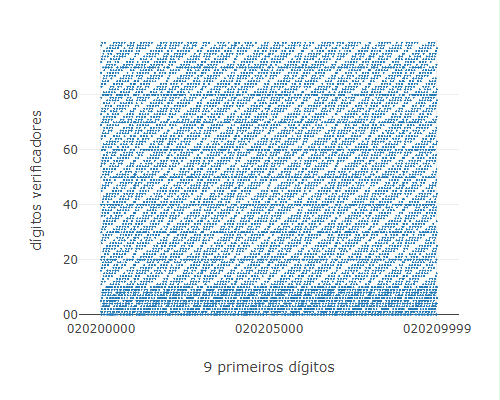
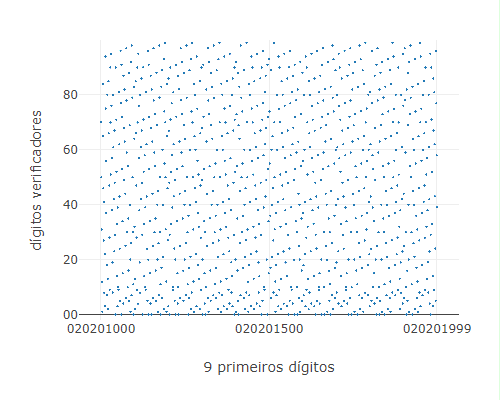
A figura a seguir mostra a mesma correlação para um conjunto de dados ainda mais restrito: 1 mil CPFs entre 020201000 e 020201999. Novamente, mostra que as probabilidades dos conjuntos de dígitos verificadores são bem distribuídas ao longo de todo o intervalo de CPFs, mas os "vazios" diagonais são muito mais bem definidos.
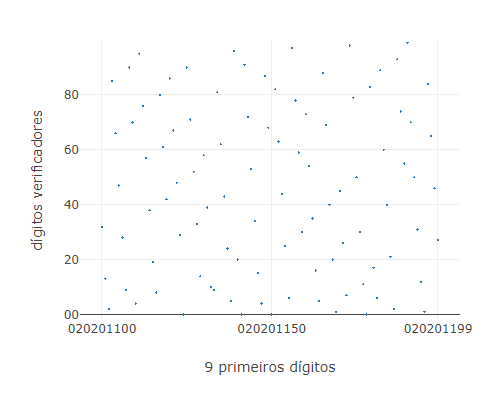
A distribuição relativamente homogênea dos conjuntos de dígitos verificadores, dentro dos limites estatísticos, fica ainda mais evidente na figura a seguir, que mostra a mesma correlação para um conjunto de dados ainda mais restrito: 100 CPFs entre 020201100 e 020201199.
O algoritmo para o cálculo dos dígitos verificadores do CPF não é perfeito mas é bastante apropriado para a "redução" de números "grandes" parcialmente aleatórios para números que obedecem uma distribuição bastante próxima de uma distribuição uniforme de probabilidades.
Considere, por exemplo, um número de matrícula em uma universidade qualquer. Nessa universidade, o número de matrícula tem 8 dígitos: os 2 primeiros referem-se ao ano de ingresso; os 3 seguintes, ao número do curso; e os 3 últimos a alguma ordem de classificação (alfabética, nota no exame de entrada). Na lista de matriculados em uma disciplina, os 5 primeiros números têm grandes chances de serem os mesmos para muitos alunos (aqueles que entraram no mesmo ano no mesmo curso), com algumas exceções (alunos de anos anteriores ou de outros cursos que fazem a mesma disciplina). Já os 3 últimos números tendem a ser "baixos". Por exemplo, se um curso tem 50 vagas, esses números não serão maiores que 050.
Será que gerar números determinísticos de 2 dígitos a partir do número de matrícula de 8 dígitos apenas "pinçando" dois exemplares (o 2o. e 7o. algarismos, por exemplo) leva a distribuições mais ou menos enviesadas do que a que pode ser construída com esse algoritmo?
Fica o desafio.
Para os mais interessados em técnicas de criação de dígitos verificadores e suas estatísticas, sugiro começar com Check digit na Wikipedia.